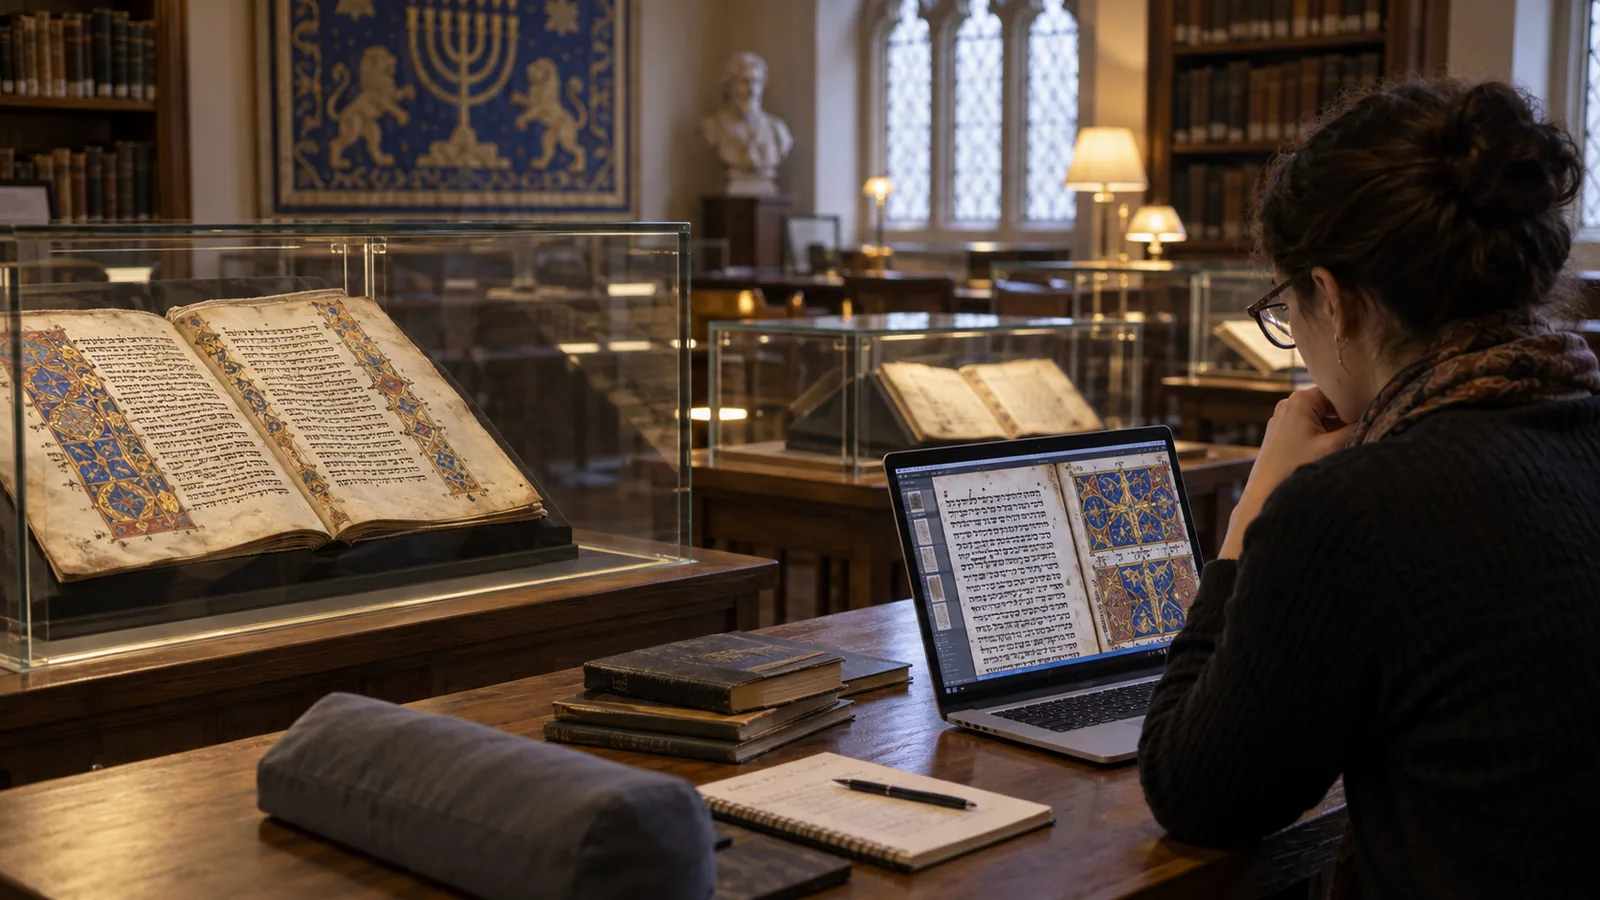
Le 24 septembre 2026, une conférence de la BnF à Richelieu a présenté un travail sur les manuscrits en caractères hébreux conservés à Paris et à la Bibliothèque apostolique vaticane. L'enjeu précis est de rendre interrogeables des pages numérisées qui, faute de transcription, restent difficiles à explorer par recherche textuelle. La présentation officielle de la conférence rattache cette démarche au projet ERC MiDRASH.
Pourquoi ces fonds résistent encore à la recherche plein texte
La BnF indique que les manuscrits hébreux conservés avec ceux de la Bibliothèque apostolique vaticane représentent plusieurs centaines de milliers de pages numérisées. L'image permet de regarder une page, mais elle ne suffit pas à interroger toutes les occurrences d'un mot ni à rapprocher rapidement des passages éloignés. Pour de nombreux chercheurs, il faut encore parcourir les reproductions une à une ou dépendre des descriptions existantes. Le projet ERC MiDRASH tente de franchir cette étape en transformant les images en textes interrogeables grâce à la reconnaissance automatique de l'écriture.
Cette tâche est différente de l'OCR appliquée à un imprimé moderne. Les écritures varient selon les mains, les époques et les usages ; les abréviations, corrections et marginalia brouillent la séparation entre les éléments. Une page peut contenir plusieurs colonnes ou des ajouts plus tardifs. Même lorsqu'un modèle reconnaît correctement des lettres, il doit encore déterminer dans quel ordre lire les fragments et ce qui appartient au texte principal. La qualité du résultat ne se juge donc pas uniquement à sa capacité de produire une chaîne de caractères.
Des images abondantes, mais peu de textes consultables
La BnF indique que les deux ensembles représentent plusieurs centaines de milliers de pages, numérisées depuis une vingtaine d'années. Une image permet de voir une page ; elle ne permet pas automatiquement de chercher un mot ou une formule dans l'ensemble du corpus. Pour cela, il faut reconnaître l'écriture et transformer l'image en texte exploitable. Cette étape est particulièrement délicate lorsqu'on travaille sur des manuscrits de périodes et de mains différentes, avec des pages parfois abîmées ou annotées.
La conférence a annoncé la présentation d'une chaîne de traitement destinée à ces deux collections. Son objectif est d'ouvrir la voie à des recherches à grande échelle, au repérage de textes oubliés et, à terme, à certaines tâches de catalogage. Ce sont des possibilités de recherche exposées par les intervenants, pas l'annonce que chaque page aurait déjà été lue et validée automatiquement.
À quoi sert la reconnaissance automatique de l'écriture ?
Si une transcription est suffisamment fiable, un chercheur peut retrouver un nom, une expression ou une variante dans des documents conservés dans des institutions différentes. Il peut ensuite retourner à l'image pour examiner l'écriture originale, la mise en page, les corrections et la matérialité du manuscrit. Le texte calculé sert de porte d'entrée ; l'image et l'objet conservent leur valeur de source.
Une reconnaissance erronée peut manquer un passage ou créer une ressemblance qui n'existe pas. Les graphies anciennes, les changements de langue et l'état des reproductions influencent les résultats. Les spécialistes doivent donc contrôler les rapprochements, dater les témoins et replacer les textes dans leur histoire. L'outil accélère l'exploration sans décider seul de la provenance ou du sens d'un document.
Transcrire, chercher, puis vérifier
Le parcours d'une page numérisée peut être résumé en trois opérations distinctes. La reconnaissance de l'écriture produit d'abord une transcription proposée par le système. L'indexation permet ensuite de retrouver une suite de mots dans un grand ensemble. Enfin, le chercheur confronte le résultat à l'image et, si nécessaire, au manuscrit conservé. Une bonne recherche ne confond pas ces étapes : une expression absente des résultats peut exister dans une page mal reconnue, tandis qu'une expression trouvée peut provenir d'une erreur de lecture.
Comment mesurer la qualité d'une transcription automatique ?
Pour apprécier un système de reconnaissance d'écriture, il ne suffit pas d'examiner les pages les plus nettes. Il faut tester plusieurs périodes, mains, types de documents et états de conservation. Une page régulière copiée par un scribe entraîné peut être plus facile qu'un feuillet couvert de corrections et d'ajouts. Le taux moyen d'erreur d'un corpus risque de masquer les groupes de pages les moins bien traités. Une évaluation utile indique donc où l'outil fonctionne, où il échoue et comment ces écarts sont signalés au chercheur.
La recherche plein texte a ses propres critères. Une transcription imparfaite peut encore permettre de trouver de nombreux passages ; mais si certains mots importants sont fréquemment mal reconnus, le chercheur pourrait croire à tort qu'ils sont absents. Les variantes orthographiques et les abréviations compliquent également les requêtes. Les outils devront peut-être proposer plusieurs formes de recherche et laisser voir la page d'origine à côté du résultat textuel.
Le contrôle humain peut produire un cercle vertueux : une correction documentée améliore une transcription et peut servir à affiner le traitement de pages proches. Encore faut-il conserver l'historique des changements. Une transcription corrigée n'est pas la même donnée qu'une sortie brute du modèle ; les deux peuvent être utiles selon la question de recherche.
Une nouvelle échelle de recherche, avec de nouveaux biais
La conférence du 24 septembre a été présentée par des spécialistes de la BnF et de l'EPHE. Elle promet de montrer le processus de traitement des deux collections, non d'affirmer que tous les manuscrits sont déjà transcrits sans erreur. Ce point est essentiel : un outil qui recherche dans plusieurs centaines de milliers de pages peut changer les questions posées par les chercheurs, mais ses réponses dépendent des écritures qu'il reconnaît le mieux. Si certains types de mains ou de pages sont moins bien traités, ils risquent d'apparaître moins souvent dans les résultats alors qu'ils restent présents dans le fonds.
Les métadonnées jouent un rôle tout aussi important que le modèle. Une page sans cote fiable ou sans lien vers son exemplaire ne peut pas être correctement comparée à une autre. La constitution d'un corpus interrogeable demande donc un travail de conservation, de catalogage et de contrôle humain en plus du calcul. Le résultat le plus durable sera peut-être la possibilité de signaler et corriger les erreurs de transcription au fil des recherches.
Pour un lecteur non spécialiste, le projet illustre une règle générale de l'IA patrimoniale : la recherche automatique peut faire découvrir un document, mais la preuve demeure dans l'objet, sa reproduction et son contexte. C'est la possibilité de revenir à ces éléments qui rend une découverte vérifiable.
Du manuscrit isolé au corpus comparatif
La conférence présentée par la BnF associe ses collections à celles du Vatican. L'intérêt d'un traitement à grande échelle est de pouvoir rechercher des ressemblances, des variantes et des transmissions entre témoins conservés dans des institutions différentes. Un passage que l'on croyait unique peut trouver un parallèle ailleurs ; une copie peut révéler une tradition de lecture distincte. La machine aide à proposer ces rapprochements, tandis que l'interprétation historique reste à établir.
Pour que la comparaison soit solide, chaque transcription doit rester reliée à sa page d'origine, à sa cote et à une indication d'incertitude. Une recherche plein texte peut faire surgir une forme orthographique inattendue ou, au contraire, manquer un passage mal reconnu. Il est indispensable de pouvoir revenir à l'image et aux informations de catalogage. Cette traçabilité transforme l'outil en aide à la recherche plutôt qu'en substitut silencieux à la source.
Ce qu'un chercheur pourra demander à un tel outil
- Retrouver une formule ou un nom présent dans plusieurs manuscrits, y compris lorsqu'une notice ne les mentionne pas.
- Comparer différentes versions d'un passage avant une étude philologique détaillée.
- Repérer des pages candidates pour un travail de catalogage ou de transcription humaine.
- Mesurer ce que la recherche ignore encore en identifiant les zones peu lisibles ou non transcrites.
Ces usages dépendent de la précision des modèles et de l'accès aux données produites. Une démonstration réussie sur quelques pages ne prouve pas que toutes les écritures d'un corpus seront traitées avec la même qualité. Les prochaines étapes devront montrer comment les erreurs sont signalées, corrigées et réinjectées dans le système.
Ce que l'ouverture du corpus change pour les humanités
La possibilité d'interroger deux grands fonds à distance peut faire apparaître des passages connus sous des formes inattendues ou dans des manuscrits peu décrits. Elle peut aussi aider les équipes de catalogage à repérer des contenus qui méritent une description plus fine. Ce sont des perspectives évoquées par la BnF, pas des découvertes déjà démontrées par chaque page du corpus.
Un historien devra toujours vérifier la date proposée pour un manuscrit, sa provenance et la place d'un passage dans l'ensemble de l'œuvre. Deux textes qui se ressemblent peuvent avoir des relations complexes : copie, citation, tradition commune ou simple formule fréquente. L'outil accélère le repérage, tandis que l'argument historique exige une comparaison raisonnée.
Pour le public, le projet offre une façon concrète de comprendre l'IA dans les bibliothèques. Elle peut rendre cherchables des images déjà conservées, sans remplacer le travail de conservation ni la compétence de ceux qui lisent les écritures et interprètent les variantes. Sa valeur dépend de la traçabilité des résultats et de leur ouverture à la critique.
Un enjeu de patrimoine autant que de technique
La numérisation des fonds protège l'accès aux images et facilite leur consultation à distance ; la transcription leur donne une nouvelle capacité de recherche. Elle ne remplace pourtant pas l'étude matérielle : support, encre, reliure, feuillets déplacés et annotations sont aussi des sources d'histoire. La meilleure approche relie l'indexation automatisée, le regard du spécialiste et la possibilité de consulter le témoin original lorsque la question le demande.
La perspective évoquée par la BnF va jusqu'à l'aide au catalogage et à la mise au jour de textes oubliés. Il faut la lire comme une voie de recherche, non comme un inventaire déjà achevé. L'intérêt public du projet tiendra aussi à la manière dont les transcriptions, corrections et références bibliographiques seront documentées pour les lecteurs futurs.
Une conférence à revoir comme point de départ
La BnF indique que la rencontre du 24 septembre est disponible en vidéo sur sa page. Le lecteur intéressé peut ainsi entendre les chercheurs expliquer le processus, ses exemples et ses limites, puis consulter les notices des manuscrits mentionnés. Cette possibilité est précieuse pour distinguer une démonstration scientifique du résumé qu'en donne un article. Elle permet aussi de vérifier les termes employés pour la reconnaissance d'écriture et pour les découvertes encore envisagées.
La vidéo documente un état du projet à cette date. Les résultats et interfaces pourront évoluer ensuite. Pour suivre MiDRASH, il faudra chercher des publications, jeux de données ou outils mis à disposition par les équipes, en vérifiant toujours la relation entre une transcription et l'image du manuscrit.
Ce que l'on peut retenir de cette rencontre
La BnF a présenté des exemples issus du patrimoine textuel juif médiéval et moderne, avec des intervenants de la BnF et de l'EPHE. Le fait marquant est le passage possible d'une collection visible sous forme d'images à un corpus que l'on peut interroger, comparer et relire. Pour suivre le projet, il faudra distinguer les démonstrations de la conférence, les résultats publiés et les transcriptions effectivement mises à disposition des chercheurs.
Cette distinction est utile au grand public aussi : « étudié avec l'IA » ne signifie pas que la machine a découvert seule une vérité historique. Elle assiste une enquête menée sur des sources précises, dont les limites doivent rester visibles.
Les corpus de la BnF et du Vatican offrent l'intérêt de rapprocher des documents aujourd'hui conservés séparément. La source officielle ne fournit toutefois pas de taux de fiabilité général pour toutes les écritures et toutes les périodes. Publier un tel chiffre sans protocole d'évaluation serait trompeur. La valeur scientifique viendra aussi de la possibilité de signaler les corrections et de savoir à quelle image correspond chaque transcription.


